
一个月连发四款,名字还都是元素名
Google 在一个月里把 Gemini 4 发成了四个型号:10 月 13 日 Argon,11 月 10 日 Carbon,11 月 12 日 Hydrogen,11 月 18 日 Neon。名字全是元素名,定位却各不相同,打开模型列表先愣一下的人不在少数。
先把结论放在这里:日常任务先用 Hydrogen,复杂的编程、研究和科学工作用 Neon,最难的长推理问题找 Carbon,Argon 留给已经跑起来的旧工作流。选型的关键不是哪个分数最高,而是哪款对得上你要做的事。下面两张图,一张分清定位,一张看清跑分。
四款模型,各自是做什么的
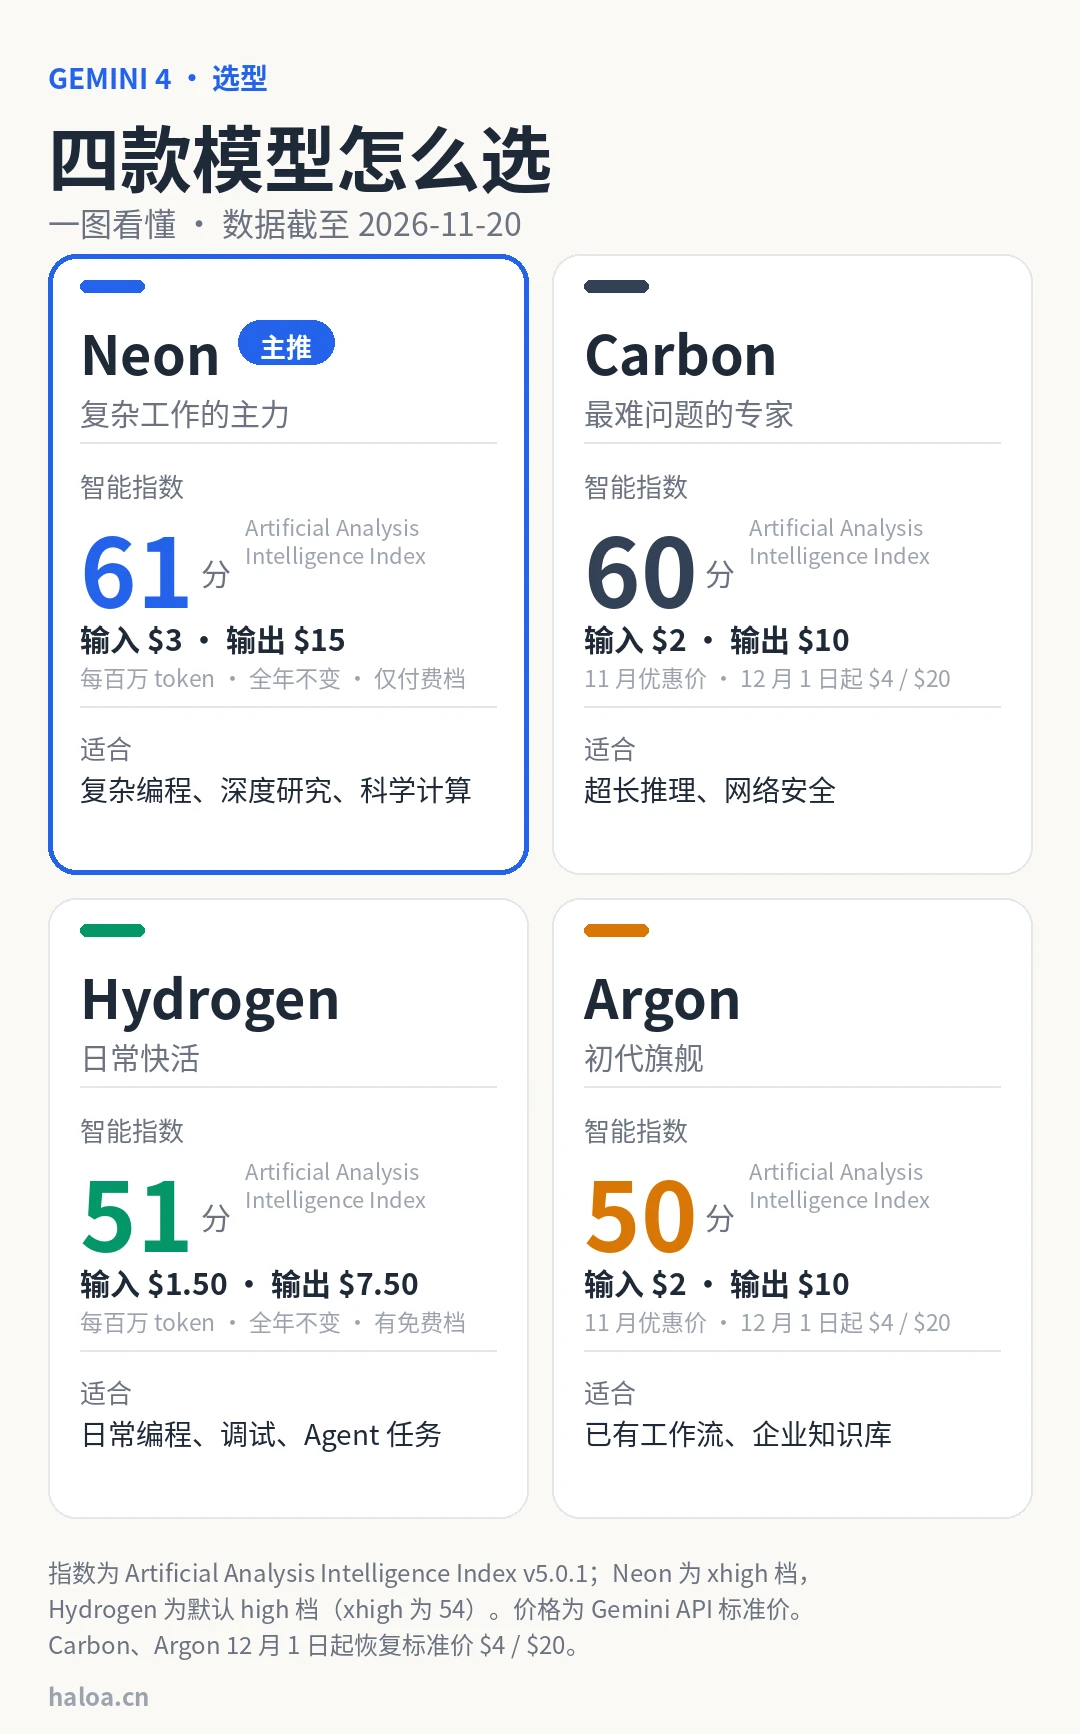
Argon 是初代旗舰。10 月 13 日最先发布,定位是高效推理,面向企业知识工作和网络安全。它曾经是 Gemini 4 的最强型号,如今分数上已被后来者超过。对已经在用它、且评测结果满足需求的工作流,没有换的必要;新开工作流,一般不再从它起手。
Carbon 是最难问题的专家。11 月 10 日发布,Google 称它为推理能力最强的 Gemini 4,面向超长推理和网络安全。它的综合指数是 60,在四款里排第二。需要注意的是,Carbon 初期优先向通过 Fairwind 计划审核的网络安全人员开放,普通用户现阶段基本碰不到它。
Hydrogen 是日常款。11 月 12 日发布,定位是快和便宜:日常编程、调试、原型、研究和 Agent 任务。它的综合指数是 51(默认 high 档),xhigh 档为 54,反而略高于 Argon 的 50。它是四款里唯一提供 API 免费档的,价格也最低。
Neon 是新的主力。11 月 18 日发布,定位在 Hydrogen 与 Carbon 之间,面向复杂软件工程、密集知识工作和科学任务。它的综合指数是 61,在四款里最高,也是 Google 推荐的高频复杂工作默认选择。Neon 只走付费档,没有免费档。
价格先看清时间:11 月和 12 月不是一个价
四款的价格都按每百万 token 计,输入与输出分开算。Neon 是输入 3 美元、输出 15 美元,全年不变。Hydrogen 是输入 1.5 美元、输出 7.5 美元,全年不变。Argon 和 Carbon 在 11 月 30 日之前是优惠价,输入 2 美元、输出 10 美元;12 月 1 日起恢复标准价,输入 4 美元、输出 20 美元。
这意味着“Neon 比 Carbon 便宜”这句话要加时间限定。按 12 月 1 日之后的标准价算,Neon 每 token 比 Carbon 便宜 25%,不是三分之一;按 11 月的优惠价算,Carbon 反而比 Neon 便宜。只看单价还不够:Neon 完成一个任务用的 token 更少,Google 的估算是每任务成本比 Carbon 低 32%;第三方 Artificial Analysis 按 11 月优惠价测算,两者每任务成本接近,Neon 约 3.74 美元,Carbon 约 3.88 美元。价格要按任务算,不按 token 算。
跑分怎么看:Neon 赢了 16 项,输了 3 项
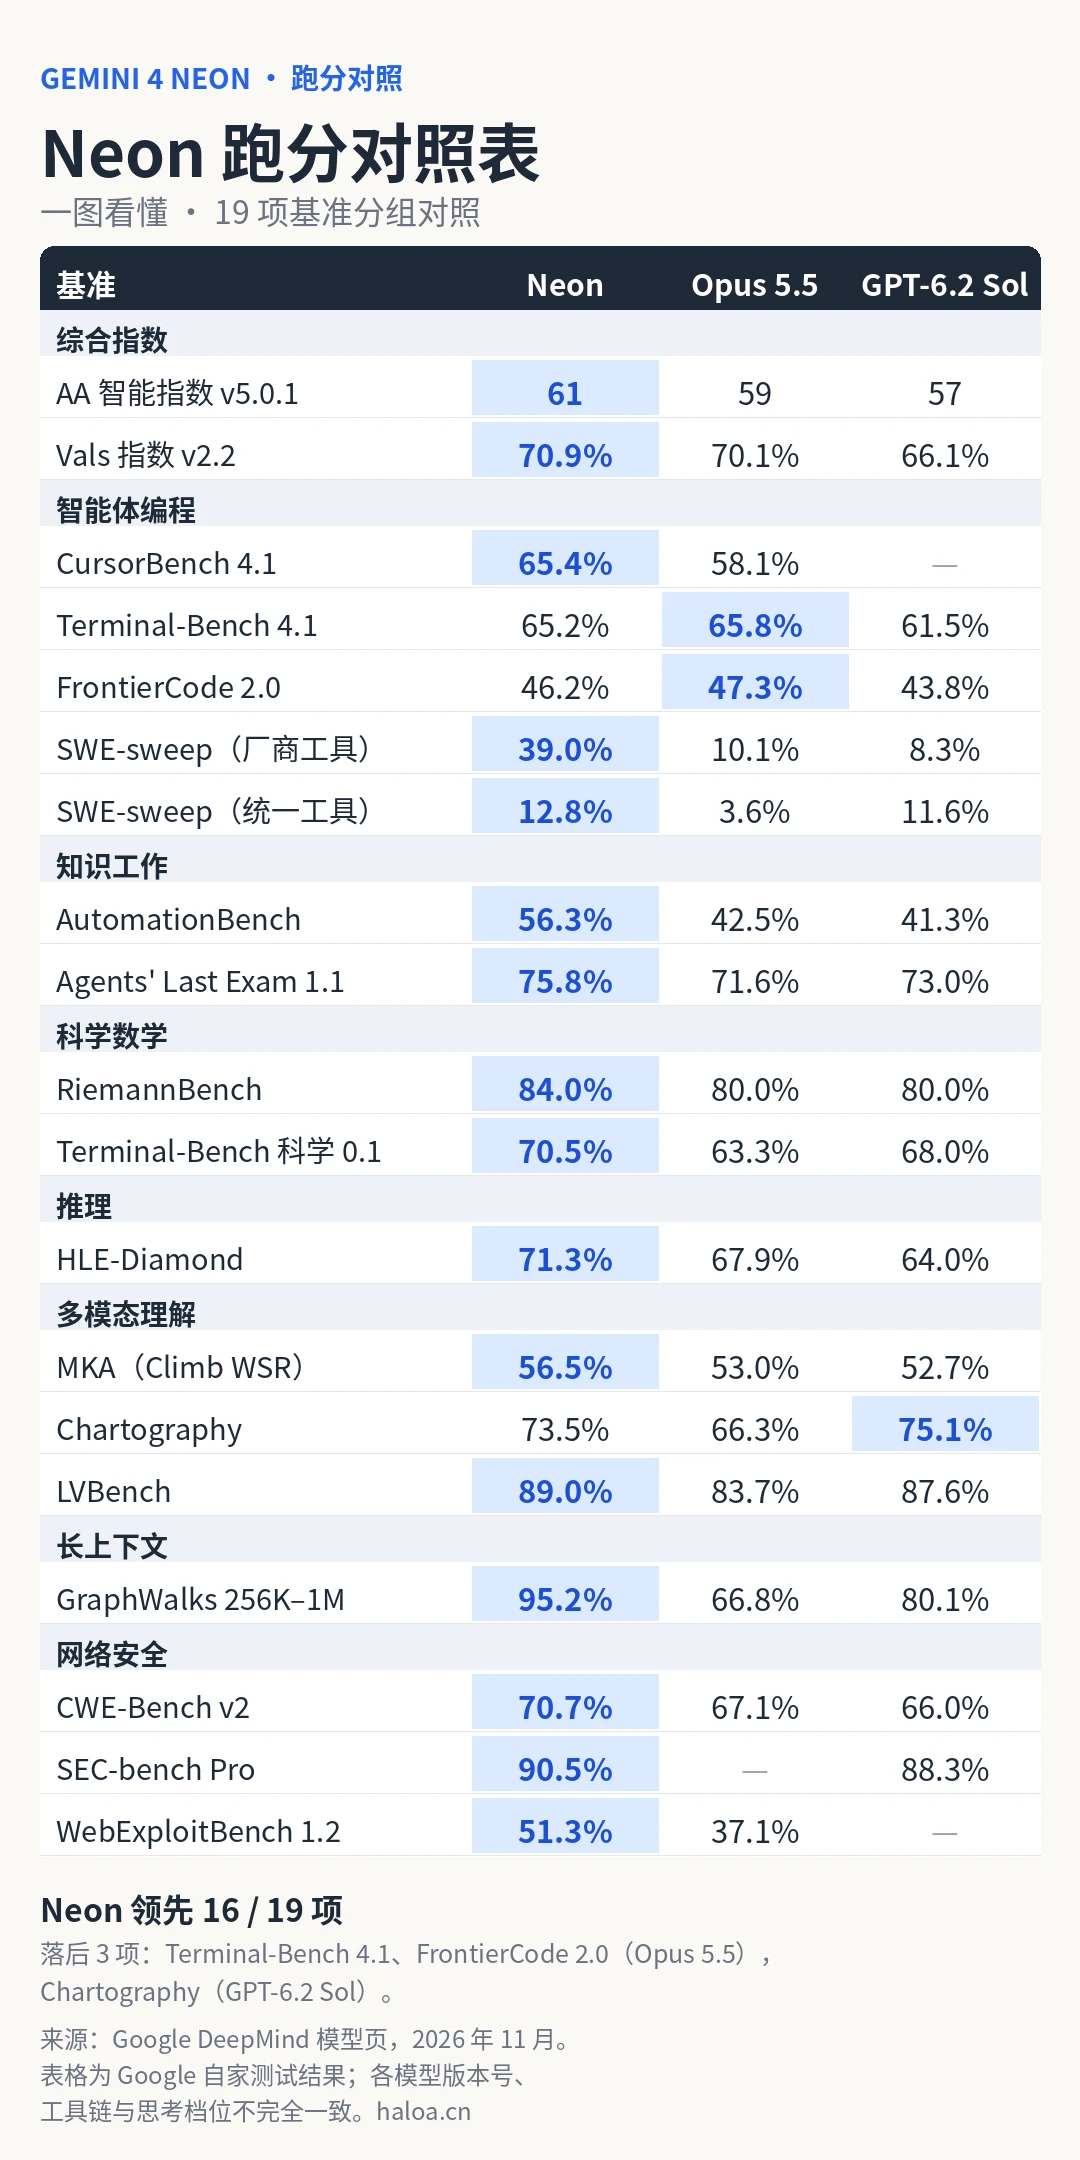
Google 在 DeepMind 模型页公布的对照表里,拿 Neon 与 Claude Opus 5.5、GPT-6.2 Sol 比了 19 项。Neon 赢了 16 项,包括两项综合指数:Artificial Analysis 智能指数 61 对 59 对 57,Vals 指数 70.9% 对 70.1% 对 66.1%。知识工作和长上下文是它拉开差距的地方:AutomationBench 56.3% 对 42.5% 对 41.3%,GraphWalks 95.2% 对 66.8% 对 80.1%。
输的三项也要看清楚。Terminal-Bench 4.1 上 Opus 5.5 以 65.8% 对 65.2% 领先,FrontierCode 2.0 上 Opus 5.5 以 47.3% 对 46.2% 领先,都是终端编程场景,差距不到 1.5 个百分点;Chartography 上 GPT-6.2 Sol 以 75.1% 对 73.5% 领先,是密集图表理解。Neon 不是全线领先,强项在综合与知识工作,终端编程和图表理解仍有对手更强。
还有两处容易看错的地方。第一,Neon 的 61 分是总榜第三,排在它前面的是 Claude Fable 5.2(65 分)和 GPT-6.2 Astra(62 分),那是总榜的领跑者,不是这张对照表里的对手;对照表里的 Opus 5.5 和 GPT-6.2 Sol 是与 Neon 同档的竞品。第二,SWE-sweep 这一项有两个数字:厂商自带工具链下 Neon 39.0% 对 10.1% 对 8.3%,统一工具下 12.8% 对 3.6% 对 11.6%,对 GPT-6.2 Sol 的差距从 30.7 个百分点缩到 1.2 个百分点——工具链不同,结果差很多,单看第一组数字会高估差距。
最后要提醒一句:这张表是 Google 自己跑的。各家模型的版本号、测试工具、思考档位并不完全一致,分数可以当作选型的地图,不当作实验室结论。真正决定用哪款的,是在自己的任务上实测。
普通用户该怎么选
在 Gemini App 里,Neon 放在“深度分析”下,Hydrogen 放在“日常帮助”下,这个分法本身就是选型建议。日常写东西、查资料、写点代码、跑自动化,先用 Hydrogen,免费档就能起步,速度也最快。任务变复杂了——多文件重构、长篇研究、科学计算——再切到 Neon,Pro 或 Ultra 订阅可用。
用 API 的话,选型逻辑一样:按量计费的任务先看 Hydrogen 的 1.5/7.5 美元;质量不够再升 Neon;只有极少数超长推理和安全场景才需要 Carbon,而且要先确认自己能不能拿到访问权限。Argon 不用特意换过去,除非现有工作流已经验证过它够用。
还有一个容易纠结的点:Neon 61 分、Carbon 60 分,只差 1 分,要不要为这 1 分多花钱?不用。1 分的差距在误差范围内,Neon 相对 Carbon 真正的优势是完成任务更快、每任务成本更低,而不是分数高 1 分。选模型看任务,不看榜。
最后聊聊我的看法
Gemini 4 的四款模型不是四档性能高低,而是一次分工:Hydrogen 管日常,Neon 管复杂工作,Carbon 管最难的问题,Argon 守住已有的工作流。Google 一个月连发四款,说明模型选型已经从“哪个最强”变成了“哪个适合这件事”。
这两张图想做的也是这件事:把定位、指数、价格、跑分收进一张图里,选之前先看一眼,选完就不用再纠结。对大多数人来说,答案其实很简单:日常 Hydrogen,复杂工作 Neon,其他的,等任务真的到了那个难度再说。
数据来源:Google DeepMind 模型页(deepmind.google)、Google 官方博客 2026 年 11 月 18 日《Introducing Gemini 4 Neon》、Artificial Analysis Intelligence Index v5.0.1、Gemini API 定价页。数据截至 2026 年 11 月 20 日;Carbon 与 Argon 的价格 12 月 1 日起调整,以官方定价页为准。





