
评审靠人眼,改动一大就看不全
一个几百行的合并请求摆在面前,改动横跨七八个文件。评审的人从头看到尾,看到后半段,前半段的细节已经模糊了。空指针、资源没释放、用户输入拼进 SQL 里的地方——这些问题不是看不懂,而是在大改动里看漏了。
Open Code Review 解决的就是这一步:机器先把改动完整过一遍,确定性规则筛掉能算出来的问题,再让模型精读剩下的部分,意见精确到行。结论先放在这里——这是阿里内部评审助手开源出来的版本,Apache-2.0 协议免费,工具本身没有付费档;但模型调用要自己接,费用另算,这一点后面单独讲清楚。
不是把 diff 扔给模型就算评审
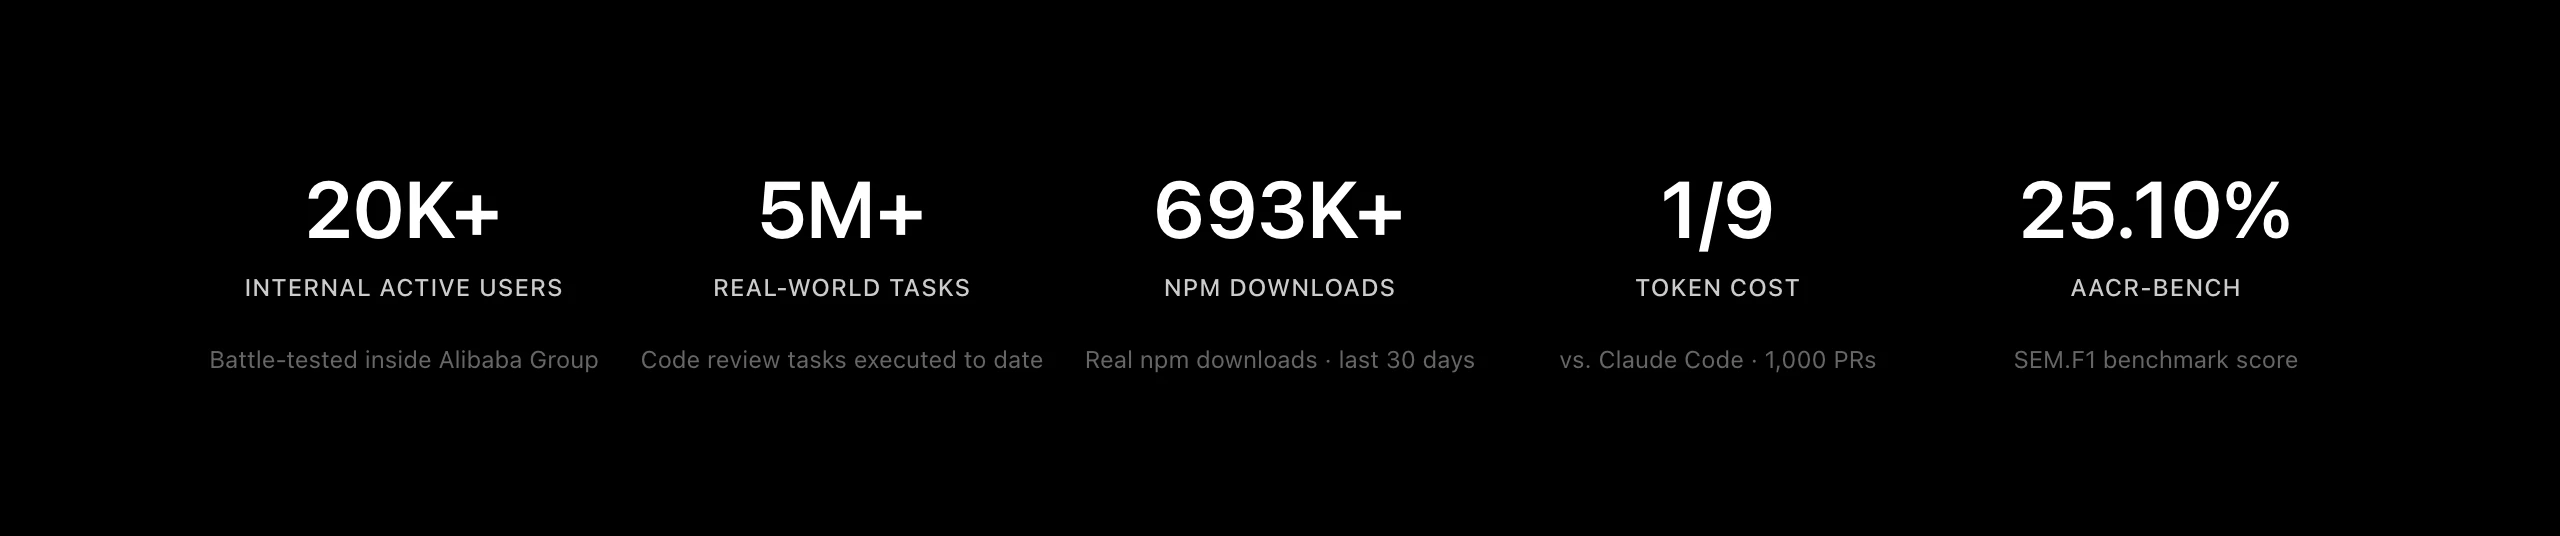
听到 AI 代码评审,第一个疑问往往是:这不就是把 diff 复制给大模型,让它说两句吗?Open Code Review 的做法不一样,它把评审拆成两段:能算出来的部分不交给模型猜,需要理解的部分再交给模型看。
确定性流水线负责前半段。先由程序决定哪些文件要审、哪些不用审,保证大改动里没有文件被悄悄跳过;再把关联文件打成一组一起审,比如中英文两份文案文件放进同一个评审单元;然后按文件特征匹配规则,空指针、线程安全、跨站脚本、SQL 注入这些内置规则只在适用的文件上生效。评论落到哪一行、写得准不准,还有独立的定位与反思模块再过一遍。
模型负责后半段。评审 Agent 能读完整文件、搜代码库、看同一批改动里的其他文件,判断一段代码在上下文里是不是真的有问题,而不只看 diff 里孤零零的几行。两种分工合在一起:规则保证覆盖和稳定,模型负责需要理解上下文的判断。
免费的是工具,模型调用费另算
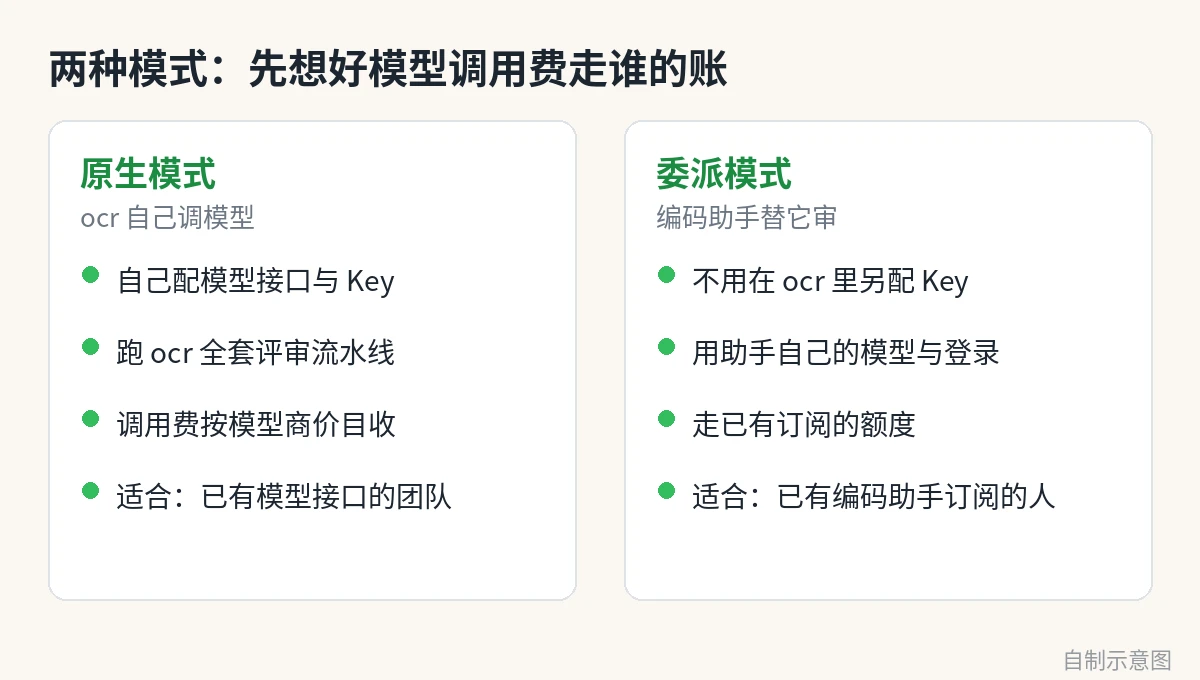
第二个疑问是价格。先说清楚:Open Code Review 本身是开源项目,Apache-2.0 协议,没有付费版、没有功能锁。花钱的地方在模型——原生模式要自己配一个模型接口,调一次收一次的钱,按模型服务商的价目来。
内置支持的模型商不少:Anthropic、OpenAI、Gemini、Qwen、DeepSeek、Kimi、Z.ai 都在官方支持列表里,也能接自己搭的兼容接口。配一次就行:ocr config provider 选服务商,ocr config model 选模型,交互界面会引导填 Key 并自动测连通性。国内读者用 Qwen、DeepSeek 这类服务商接起来更顺,但要不要把代码发给第三方服务,涉密项目得自己先定规矩。
不想再配一个 Key,还有委派模式。装上 Agent Skill 之后,让正在用的 Claude Code、Codex、Cursor 这类编码助手按 Open Code Review 的流水线和规则去评审,用的是助手自己的模型和登录,不用在工具里另填 Key。但这不等于免费——走的是已有订阅的额度,订阅本身的用量限制照样在。
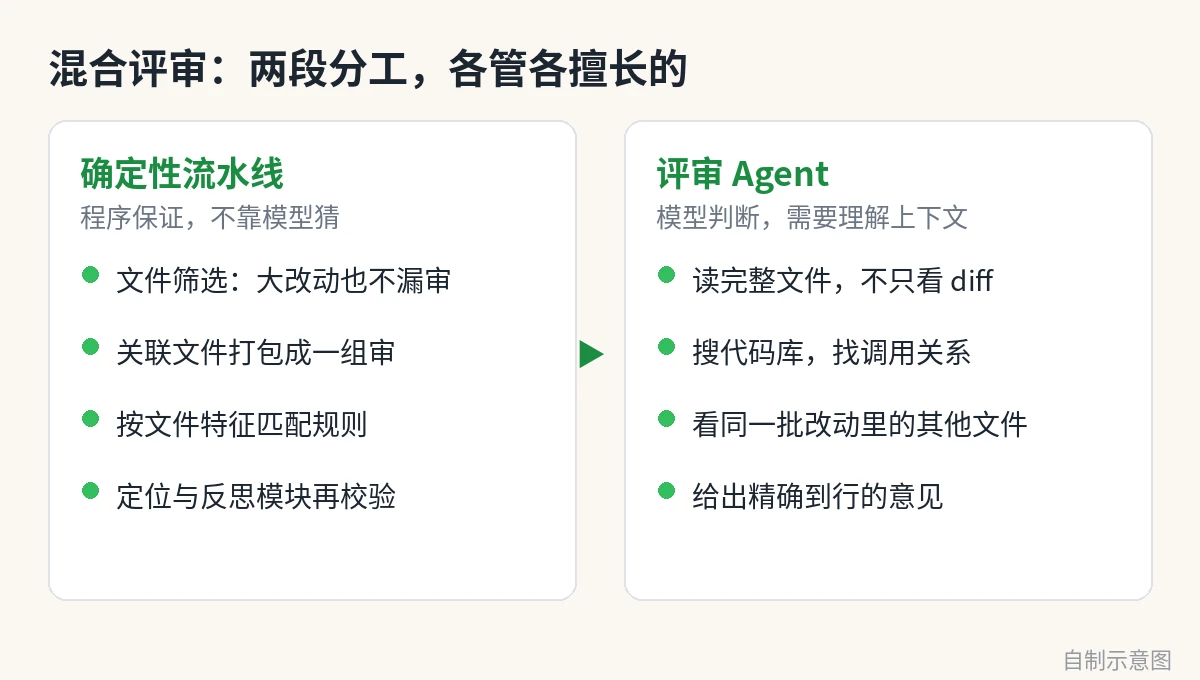
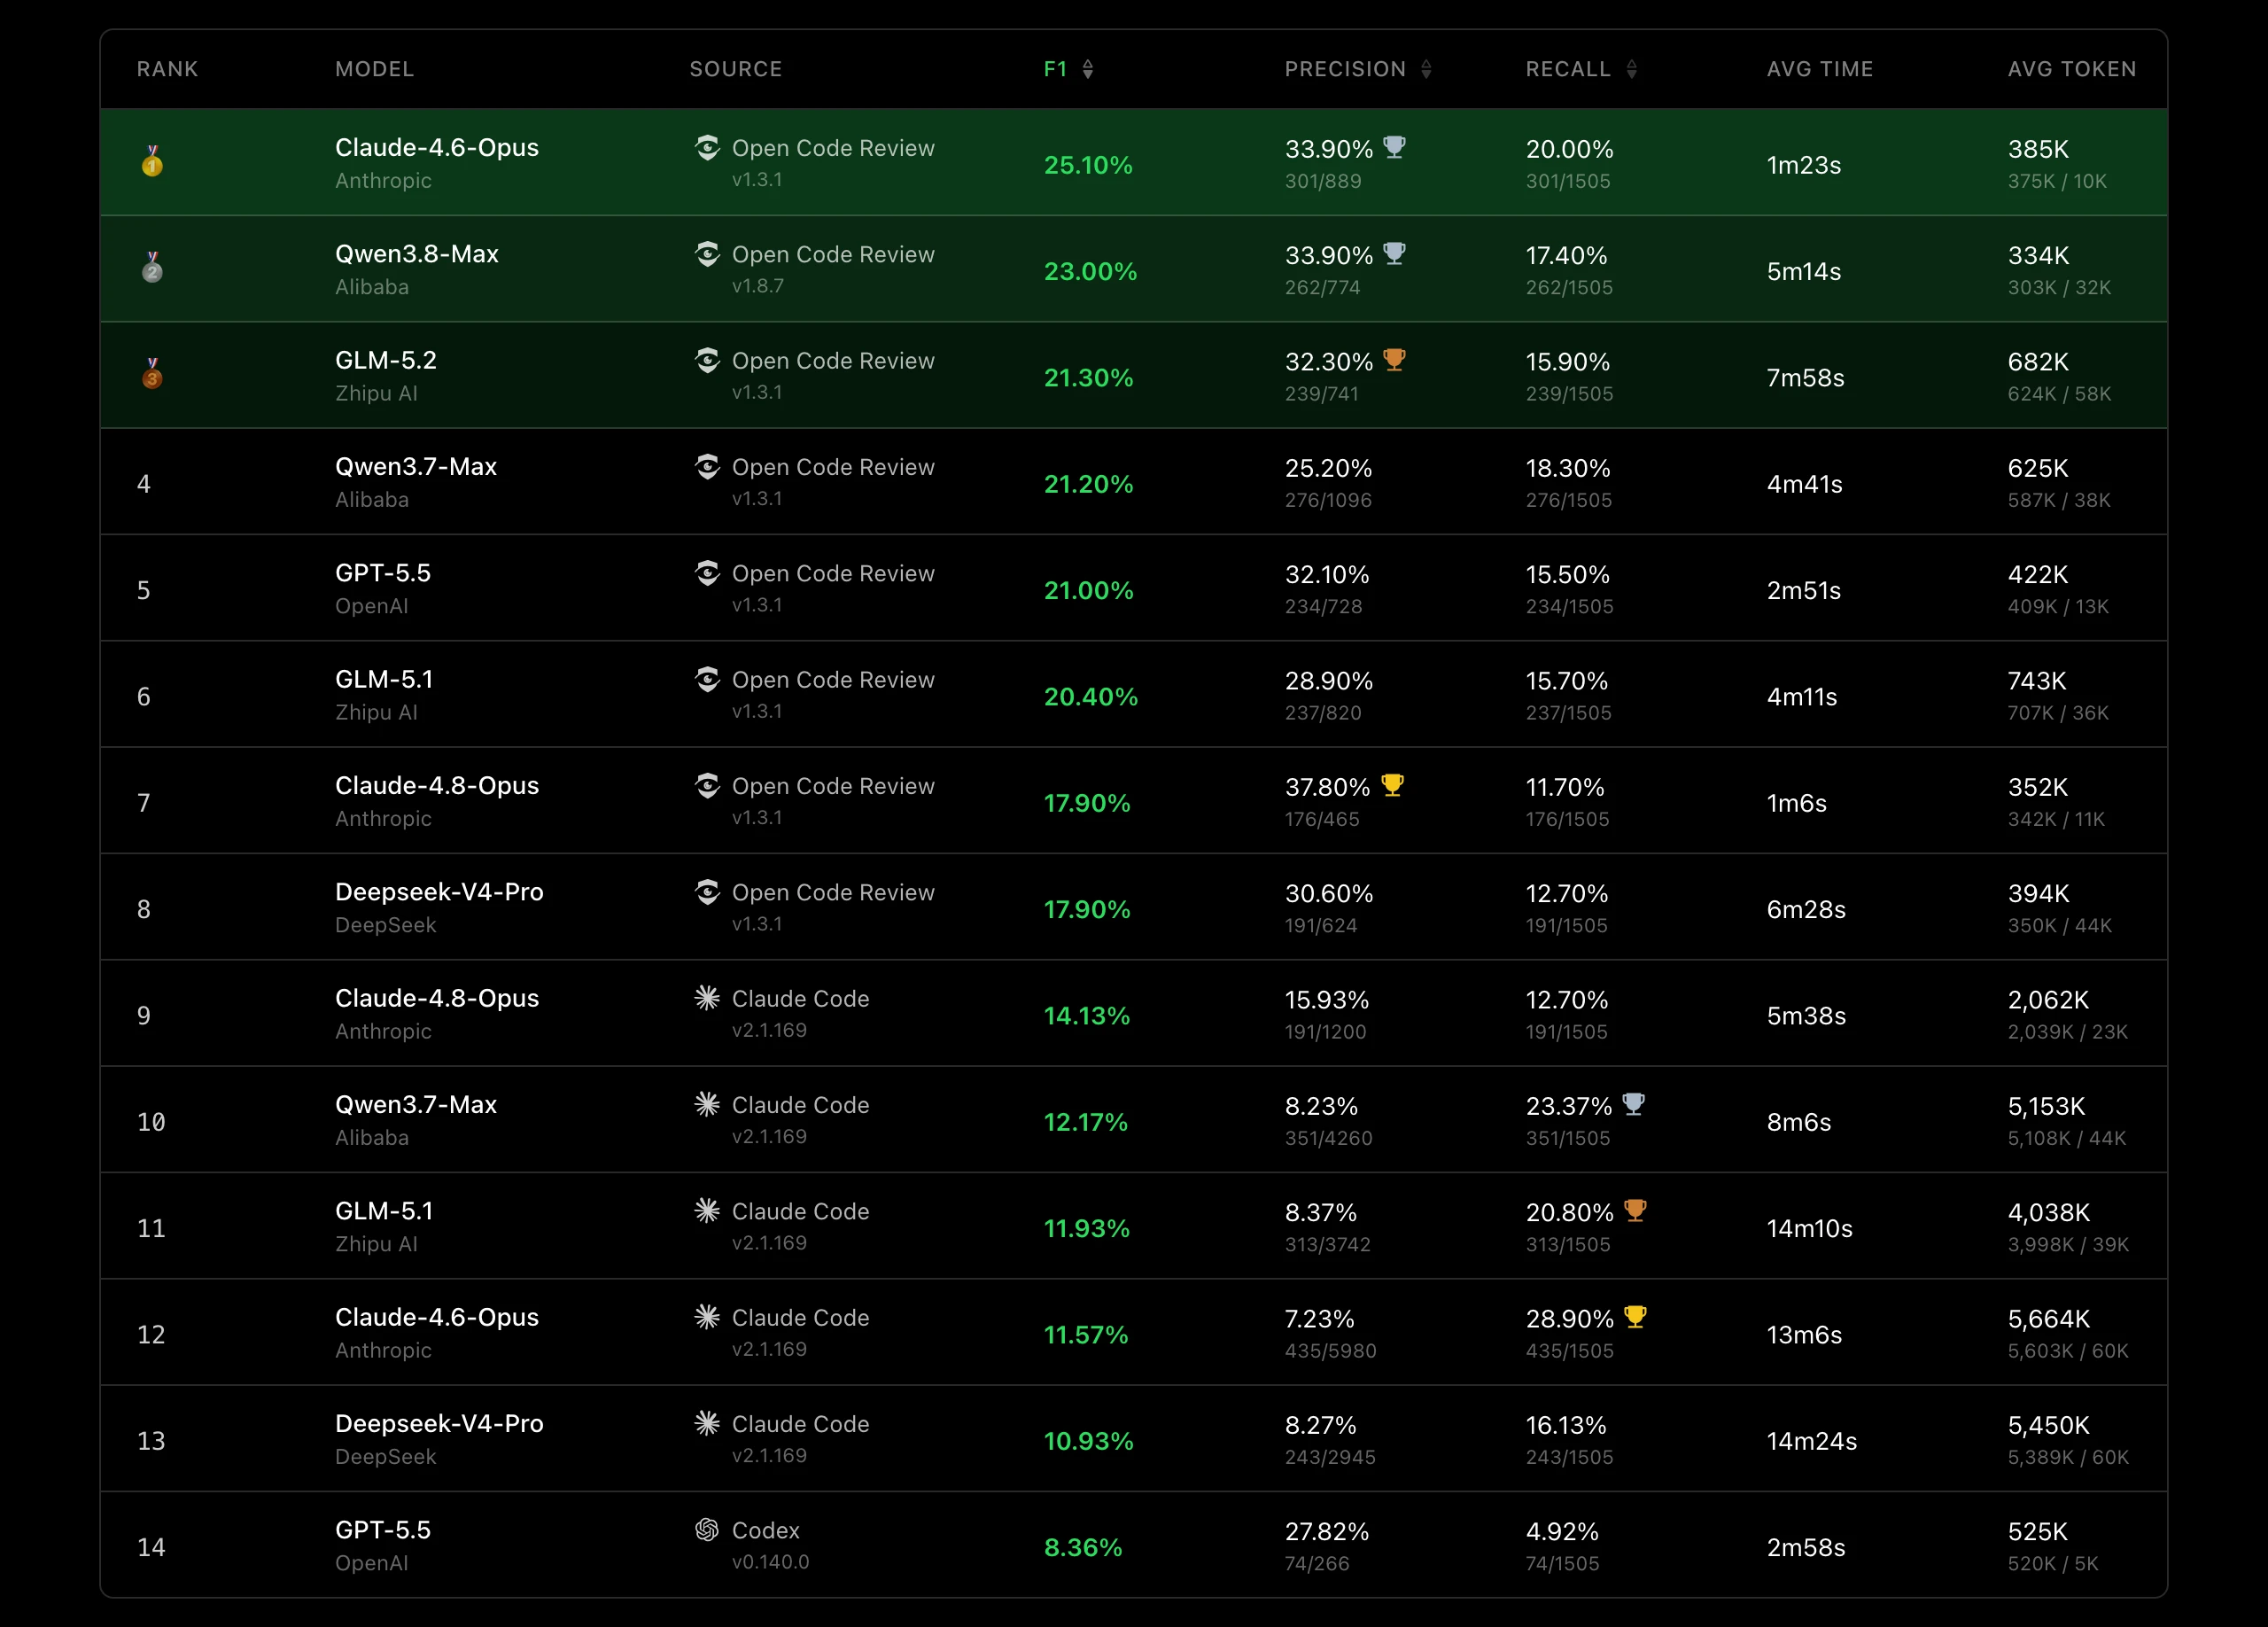
省钱是它设计里明确的一点。官方称同一模型下评审用的 token 量大约是通用 Agent 的九分之一;同一张基准表里,同款模型一次评审它用 385K token,通用 Agent 是 5,664K。代价也写在同一张表里:召回率低于通用 Agent,这是官方承认的有意取舍——宁可少报,也不乱报。
接进仓库的三条路,本地、助手、CI 都能走
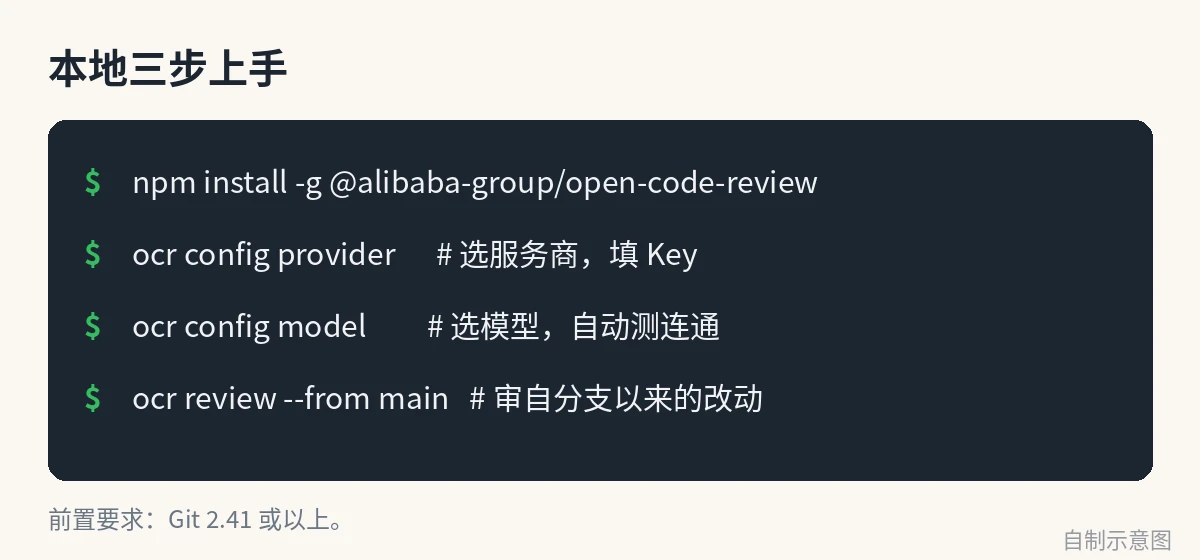
第三个疑问是好不好接。最轻的是本地命令行。装好 Node 之后一条命令装全局包,再配好模型,就能在项目里直接审:ocr review 审当前工作区的全部改动,ocr review --from main 审从主分支分出来之后的变化,ocr review --commit 加提交号只审某一次提交。没有改动可比对的旧代码库,用 ocr scan 直接扫整个仓库或某个目录。
第二条路是装进正在用的编码助手。一条命令装好 Skill:npx skills add alibaba/open-code-review,Claude Code、Codex、Cursor、Kimi Code 里就能用斜杠命令或 Skill 直接调评审,支持原生与委派两种模式,按需选。
第三条路是挂进持续集成。仓库自带 GitHub Action,工作流里填三个必填项就能跑:模型地址、鉴权 Token、模型名,审完把意见以行内评论贴回合并请求,还能把汇总固定在一条评论里反复更新。文档里还列出 GitLab CI、Gerrit 的接法,团队按自己用的平台选。
它查不出来的东西,装之前先说清楚
先说一个预期:官方基准表里,以同款模型最好的成绩为例,F1 是 25.10%,精确率 33.90%。也就是说,报出来的意见里大约三分之一是真问题,同时还有不少真问题没报出来。这不是拿来替代人工评审的,机器过完,人还是要看一遍。
再说模型依赖。评审质量跟着模型走,换个弱模型,效果会打折;规则筛得再稳,也补不回模型理解力的差距。团队用之前,先拿自家仓库跑几个真实合并请求,比只看基准数字管用。
还有两类人要慎重。第一类,代码不能出内网的团队:原生模式下改动内容要发给模型服务商,涉密项目要先定好能不能外发,或者接自己搭的兼容接口。第二类,只想点一下就全自动、不愿配 Key、不愿看配置的人:它不是开箱即用的消费级应用,配模型、选模式、调规则这几步绕不过去。
安装和使用
要求 Git 2.41 或以上,装包需要 Node。先用 npm 全局安装,再配模型:
项目地址:https://github.com/alibaba/open-code-review
npm 全局安装:npm install -g @alibaba-group/open-code-review
也可以用仓库里的 install.sh(macOS、Linux)或 install.ps1(Windows)安装脚本,或去 GitHub Release 页下载对应平台的二进制。
配好模型后进项目目录直接审:ocr review(审当前工作区全部改动),或 ocr review --from main(审自分支以来的改动)。
如果没有外网的,可以直接我们公众号下载,会更方便!
首次使用先跑 ocr config provider 选服务商、ocr config model 选模型,交互界面会引导填 Key 并自动测连通性;不想另配 Key 的,装 Skill 走委派模式,用编码助手自己的模型。





